Когда оборудование встает, цех, склад или производственная линия начинают жить в другом ритме. Остановка редко ограничивается одним станком: сбиваются графики, накапливаются заказы, растет напряжение у смены и у руководителей. Самое неприятное в таких ситуациях то, что значительная часть простоев заранее подает сигналы, но их не замечают или замечают слишком поздно.
Именно поэтому мониторинг состояния техники и нормальное плановое обслуживание работают лучше, чем привычка «чинить по факту». Если собрать данные, вовремя увидеть отклонение и заранее выделить окно на обслуживание, можно избежать многих аварийных остановок. В этой статье разберем, как это устроено на практике и что действительно помогает сократить потери времени.
Почему оборудование останавливается чаще, чем хотелось бы
Причины простоев обычно не выглядят загадочно. Чаще всего это износ узла, перегрев, загрязнение, ослабленные крепления, неправильная смазка, сбой датчика или человеческий фактор. Проблема в том, что эти вещи накапливаются постепенно и долго не бросаются в глаза.
На бумаге все выглядит просто: есть график, есть инструкции, есть ответственные. На деле оборудование работает в режиме, где мелкие отклонения легко теряются среди срочных задач. Пока нет привычки регулярно смотреть на показатели состояния, поломка кажется внезапной, хотя ее можно было предугадать.
В производственной среде особенно дорого обходятся остановки, которые происходят в пиковые часы или перед отгрузкой. В такие моменты один сбой тянет за собой другой. Поэтому снижение простоев начинается не с ремонта как такового, а с умения замечать признаки надвигающейся проблемы.
Что дает мониторинг состояния техники
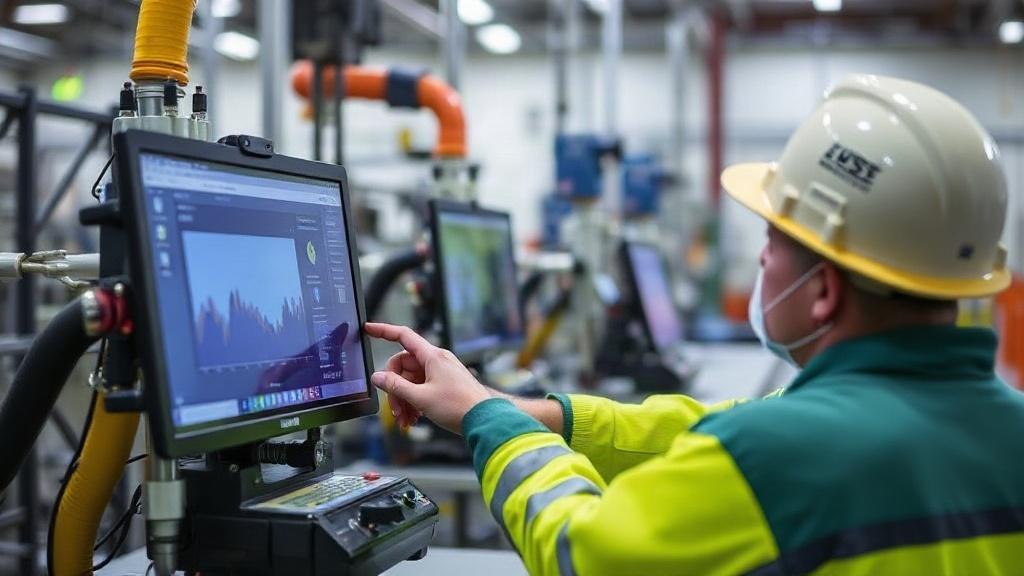
Мониторинг нужен не ради красивых графиков. Его задача проще и полезнее: показать, как оборудование ведет себя в обычной работе, и заметить, когда поведение меняется. Это может быть рост температуры, вибрации, потребления энергии, давления, времени цикла или числа ошибок в управлении.
Когда данные собираются регулярно, становится видно, что «нормально» для конкретного станка, линии или агрегата. Тогда любые отклонения уже не выглядят абстрактно. Например, если насос месяц работал с одинаковым уровнем вибрации, а потом показатель вырос, это веская причина проверить подшипники, соосность или крепление.
Мониторинг помогает и в другом важном деле: он убирает догадки. Решение о вмешательстве принимается не по ощущению, а по фактам. Это особенно полезно там, где оборудование однотипное, а нагрузка меняется от смены к смене.
Какие параметры стоит отслеживать
Набор параметров зависит от типа техники. Для одних машин важнее температура и вибрация, для других критичны давление, ток, скорость или уровень масла. Универсальной схемы нет, но есть логика: отслеживать нужно то, что чаще всего связано с поломкой именно этого узла.
Ниже показаны примеры параметров, которые часто используют в промышленности и инженерных системах.
| Тип оборудования | Что отслеживают | Зачем это нужно |
|---|---|---|
| Электродвигатели | Температуру, ток, вибрацию | Чтобы заметить перегрузку, перекос, износ подшипников |
| Насосы | Давление, расход, вибрацию, температуру | Чтобы вовремя увидеть засорение, кавитацию, повреждение узлов |
| Редукторы и приводы | Вибрацию, шум, температуру масла | Чтобы обнаружить износ шестерен и проблемы со смазкой |
| Технологические линии | Время цикла, количество ошибок, простои по причинам | Чтобы понять, где система теряет производительность |
Не стоит пытаться сразу измерять все подряд. Слишком большой массив данных часто мешает, а не помогает. Лучше выбрать несколько действительно значимых показателей и научиться читать их без лишнего шума.
Почему плановое обслуживание выгоднее аварийного ремонта
Аварийный ремонт почти всегда дороже, чем ремонт по графику. Дело не только в стоимости деталей и работы. Когда поломка случается неожиданно, приходится срочно останавливать процесс, искать специалистов, перестраивать смену и переносить заказы.
Плановое обслуживание позволяет заранее выбрать удобное окно, подготовить запчасти, инструмент и персонал. В такой схеме техника выключается не в самый напряженный момент, а в заранее согласованное время. Для бизнеса это обычно означает меньше хаоса и меньше вторичных потерь.
Есть и еще один практичный плюс. Когда обслуживание проводится регулярно, мастера чаще замечают мелкие проблемы до того, как они перерастают в серьезные. В итоге возрастает не только надежность, но и предсказуемость всей работы.
Что входит в хорошее плановое обслуживание
Плановое обслуживание не сводится к формальной отметке в журнале. Это конкретный набор действий, привязанный к типу оборудования, условиям эксплуатации и реальной нагрузке. Если техника работает в пыли, жаре или под высокой нагрузкой, интервалы и список работ должны это учитывать.
Обычно в такой план входят проверка узлов, смазка, очистка, подтяжка соединений, контроль расходников, замена элементов с ограниченным ресурсом и тестовый запуск после работ. Для некоторых систем добавляют калибровку, проверку датчиков и диагностику программной части.
Самая частая ошибка здесь — делать обслуживание «как всегда», не глядя на фактическое состояние. Если станок почти не нагружен, а его обслуживают так же часто, как линию, работающую в три смены, ресурсы уходят не туда. Гораздо полезнее опираться на данные и условия эксплуатации.
Как связать мониторинг и обслуживание в одну систему
Сильный эффект появляется тогда, когда мониторинг не живет отдельно от службы эксплуатации. Сами по себе датчики и журналы не спасают от простоев, если данные никто не использует. Нужна простая и понятная схема: измерили, заметили отклонение, приняли решение, выполнили обслуживание, проверили результат.
На практике это часто выглядит так. Датчик показывает рост вибрации или температуры, система или инженер фиксирует сигнал, после чего оборудование ставят в очередь на проверку. Если отклонение подтверждается, обслуживание проводят до аварии, а не после нее. Такой подход экономит и время, и нервы.
Если в компании уже есть журнал отказов, его стоит связать с данными мониторинга. Тогда можно увидеть повторяющиеся сценарии: какой узел ломается чаще, после какого срока работы появляются первые признаки, в какое время года риски выше. Именно из таких наблюдений складывается зрелая система обслуживания.
Как выглядит рабочий цикл
Удобно смотреть на процесс как на короткий цикл, где каждый шаг понятен. Это помогает не терять данные и не откладывать реакцию на потом. Когда схема закреплена, сотрудники меньше спорят о том, кто и что должен делать.
- Сбор показателей в реальном времени или по графику.
- Сравнение текущих значений с нормой и историей.
- Выявление отклонений и их причин.
- Назначение проверки или обслуживания.
- Фиксация результата после работ.
Такой цикл кажется простым, но именно в простоте его сила. Чем меньше лишних шагов и двойной работы, тем выше шанс, что система будет использоваться регулярно, а не только в отчетах.
Какие инструменты помогают следить за состоянием оборудования
Инструменты мониторинга бывают разными, и это хороший знак. Значит, можно подобрать решение под размер предприятия и бюджет, не пытаясь сразу строить сложную цифровую архитектуру. Иногда достаточно базовых датчиков и нормального журнала в электронной системе.
Для более чувствительных участков используют вибродиагностику, тепловизионный контроль, анализ масла, датчики температуры и давления, счетчики циклов и системы диспетчеризации. Важно не количество приборов, а то, насколько понятно по ним принимать решения.
Отдельный разговор — программное обеспечение. Оно полезно тогда, когда не просто хранит цифры, а показывает динамику, предупреждает о выходе параметров за пределы и помогает планировать работы. Без этого данные легко превращаются в архив, который никто не открывает.
Что особенно удобно для небольших предприятий
Небольшим компаниям не всегда нужен дорогой комплекс. Часто хватает нескольких датчиков на самых уязвимых узлах, таблицы учета отказов и четкого регламента осмотра. Это уже дает заметный эффект, если сотрудники реально смотрят на показатели и реагируют на них.
Я видел, как на одном небольшом участке простой от компрессора сокращали без сложной автоматизации. На критичном узле поставили контроль температуры и давления, а мастер раз в смену сравнивал данные с рабочей нормой. После этого несколько проблем заметили до остановки, и это сэкономило не один рабочий день.
Для малого и среднего бизнеса часто важнее не масштаб, а дисциплина. Если система простая, понятная и не требует лишних действий, ее используют регулярно. А регулярность здесь решает почти все.
Как собрать данные так, чтобы они помогали, а не мешали
Сбор данных имеет смысл только тогда, когда он связан с действием. Если каждый датчик добавляет новые строки в таблицу, но никто не понимает, что делать при отклонении, польза быстро тает. Поэтому еще до запуска системы стоит определить, какие значения считаются нормой, а какие требуют реакции.
Нужны не только цифры, но и контекст. Одно дело, если температура выросла в жаркий день, и совсем другое, если тот же рост случился при обычной нагрузке и чистом фильтре. Контекст помогает не ошибиться и не останавливать оборудование без причины.
Полезно фиксировать дату, время, смену, режим работы и проведенные действия. Тогда любой повторяющийся сбой легче распознать. Через несколько месяцев такие записи превращаются в рабочую память предприятия.
На что обращать внимание в первую очередь
Есть признаки, которые особенно часто предшествуют простою. Их не всегда видно с первого взгляда, но они хорошо заметны в динамике. Чем раньше их поймать, тем меньше риск аварийной остановки.
- Рост температуры без очевидной причины.
- Увеличение вибрации или шума.
- Скачки тока, давления или расхода.
- Частые мелкие сбои, которые раньше не повторялись.
- Увеличение времени цикла или падение производительности.
Если такие изменения фиксируются регулярно, они перестают быть случайностью. В этот момент уже можно говорить не о разовой неприятности, а о тенденции, которую стоит проверить технически.
Как назначать обслуживание по данным, а не по привычке
Привычка обслуживать оборудование по календарю удобна, но не всегда разумна. Один узел может спокойно работать дольше установленного срока, а другой потребует внимания раньше, хотя в графике это не видно. Поэтому хороший подход сочетает календарный план и реальное состояние.
На практике это означает, что базовые процедуры выполняются по регламенту, а дополнительные работы назначаются по сигналам мониторинга. Такой гибридный подход снижает риск поломки и не заставляет ремонтную службу делать лишнюю работу. В итоге ресурсы расходуются точнее.
Особенно полезно выделять оборудование по степени критичности. Если остановка одного станка почти не влияет на выпуск, а отказ другого парализует участок, логика обслуживания у них должна быть разной. Это простой принцип, но его часто игнорируют.
Роль персонала: техника не спасает сама по себе
Даже самая удачная система мониторинга не работает, если сотрудники не понимают, зачем она нужна. Мастеру, оператору и инженеру важно видеть не набор цифр, а конкретную связь между показателем и риском остановки. Тогда сигнал не теряется в потоке обычных задач.
Хорошо, когда у людей есть понятные инструкции на случай отклонений. Что делать при росте температуры? Кому сообщать о вибрации? В какой момент останавливать узел, а когда достаточно наблюдения? Без таких ответов сигнал может быть замечен, но так и не доведен до действия.
Обучение тоже не должно быть формальным. Лучше короткие регулярные разборы реальных случаев, чем редкие длинные лекции. Когда сотрудники видят, как простой возник из-за пропущенного признака, отношение к мониторингу меняется быстро и без лишних слов.
Какие ошибки допускают чаще всего
Ошибок обычно немного, но каждая из них дорого обходится. Они повторяются на разных предприятиях, потому что кажутся мелкими и не требуют срочного внимания. На деле именно из таких мелочей складываются длительные простои.
- Ставят датчики, но не назначают ответственных за реакцию.
- Собирают данные, но не сравнивают их с нормой и историей.
- Планируют обслуживание по привычке, не учитывая нагрузку.
- Не фиксируют причины прошлых отказов.
- Останавливают технику слишком поздно, когда повреждение уже велико.
Если исключить хотя бы часть этих ошибок, результат обычно заметен уже в первые месяцы. Не обязательно менять всю систему сразу. Часто хватает нескольких точечных шагов, чтобы снизить число внеплановых остановок.
Как измерить, стало ли лучше
Чтобы понять, работает ли новая схема, нужны простые показатели. Самый очевидный из них — общее время простоя. Но смотреть только на него недостаточно, потому что важно еще и то, по каким причинам оборудование встает и насколько быстро его возвращают в строй.
Полезно отслеживать частоту аварийных остановок, среднее время восстановления, долю плановых работ и количество повторяющихся отказов. Если после внедрения мониторинга аварий стало меньше, а обслуживание начали проводить спокойнее и точнее, это хороший признак.
Иногда эффект проявляется не сразу. Сначала растет количество выявленных отклонений, и это может пугать. Но потом становится ясно, что система просто начала видеть то, что раньше скрывалось до момента поломки. Тут важно не перепутать рост обнаружений с ростом проблем.
Удобные показатели для контроля
| Показатель | Что показывает | Почему полезен |
|---|---|---|
| Время простоя | Сколько часов оборудование не работало | Показывает прямые потери |
| Число аварийных остановок | Сколько раз произошел внеплановый отказ | Помогает оценить надежность |
| Среднее время ремонта | Сколько занимает восстановление работы | Показывает скорость реакции службы |
| Доля плановых работ | Какой объем обслуживания выполнен заранее | Помогает понять, насколько система уходит от аварийности |
Что особенно важно для производственной практики
На производстве редко бывает одна причина простоя. Обычно это цепочка: слабый контроль состояния, несвоевременная реакция, неготовые запчасти, неудобный график работ. Поэтому и решение должно быть комплексным, но без лишней сложности.
Если говорить совсем по-простому, полезно наладить три вещи. Первая — видеть состояние оборудования в динамике. Вторая — заранее планировать обслуживание критичных узлов. Третья — фиксировать опыт, чтобы одна и та же поломка не повторялась по кругу.
Я не раз видел, как после простого наведения порядка в осмотрах и журнале отказов ситуация заметно менялась. Не из-за дорогих технологий, а из-за того, что люди переставали гадать и начинали опираться на данные. В этом, пожалуй, и есть главная практическая ценность мониторинга.
С чего начать без лишней нагрузки на команду
Начинать лучше с самого критичного оборудования. Обычно это те узлы, остановка которых бьет по выпуску сильнее всего. Когда выбран приоритет, становится понятнее, куда ставить датчики, что измерять и как часто проводить осмотры.
Затем стоит описать текущие проблемы: какие поломки повторяются, сколько времени уходит на восстановление, где чаще всего теряются часы. Такой список быстро показывает, где потери самые заметные. После этого уже легче выбрать конкретные действия, а не распыляться на все сразу.
Дальше нужна проверка на практике. Небольшой пилотный участок покажет, хватает ли выбранных параметров, понятны ли сигналы и не перегружает ли система сотрудников. Это полезнее, чем сразу разворачивать все на весь парк машин.
Какой результат дает разумный подход
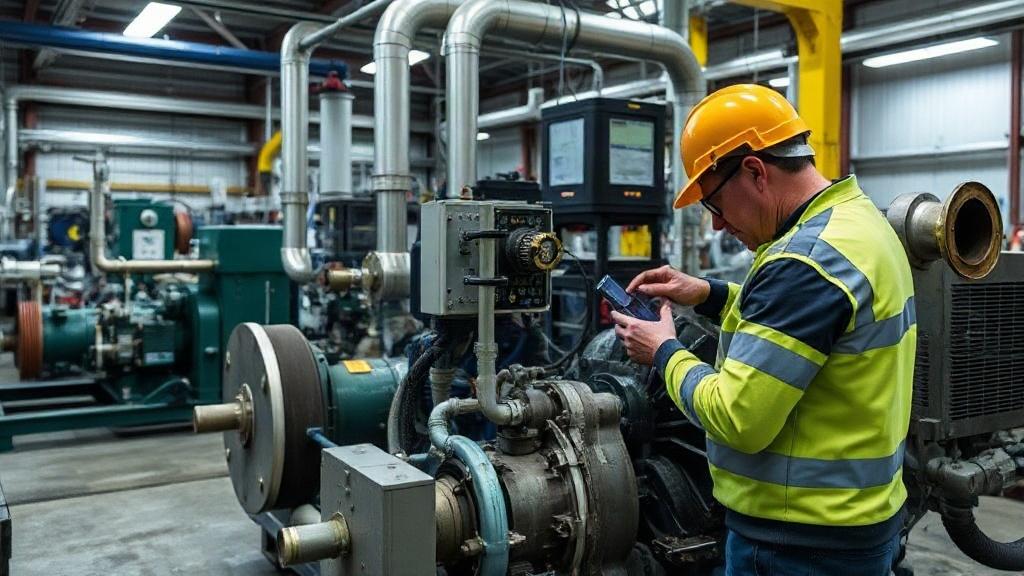
Когда мониторинг и обслуживание работают вместе, предприятие начинает жить спокойнее. Не в смысле полной тишины, конечно, а в смысле предсказуемости. Меньше внезапных остановок, меньше срочных вызовов, меньше дорогих авралов.
Особенно заметен эффект там, где оборудование стареет или работает в тяжелых условиях. В таких случаях полностью убрать поломки невозможно, но можно сделать их редкими и менее разрушительными. И это уже серьезная экономия времени и ресурсов.
Если свести все к одной мысли, то ответ на вопрос, как сократить простои, лежит не в одной суперсистеме, а в дисциплине внимания. Нужно видеть признаки раньше, чем станок остановится, и не откладывать обслуживание до момента, когда поломка уже вышла из-под контроля. Тогда техника работает дольше, а процесс становится заметно устойчивее.